作者:王林 Lincoln | MindsLeap 创始人兼 CEO | Founders Space 合伙人兼中国区 CEO | MindsLeap 企业家 AI 俱乐部创始人
AI 的下一场竞争,可能不是谁拥有更大的模型,而是谁先把 AI 研发本身变成一个可以持续迭代的系统。
这个判断听起来像科幻,但最近已经有一部分进入了工程现场。Anthropic 公开讨论了一个非常敏感的问题:AI 是否正在帮助人类制造下一代 AI。它的结论并不是“递归式自我改进已经实现”,而是更克制,也更值得重视:现在还没有到那一步,但 AI 已经在加速 AI 的开发。
递归式自我改进,英文是 Recursive Self-Improvement,通常缩写为 RSI。最强版本的想象是,一个 AI 系统能够设计、训练并改进自己的继任者,继任者又继续完成下一轮改进。真正重要的变化,是改进 AI 的工作不再完全由人来完成。
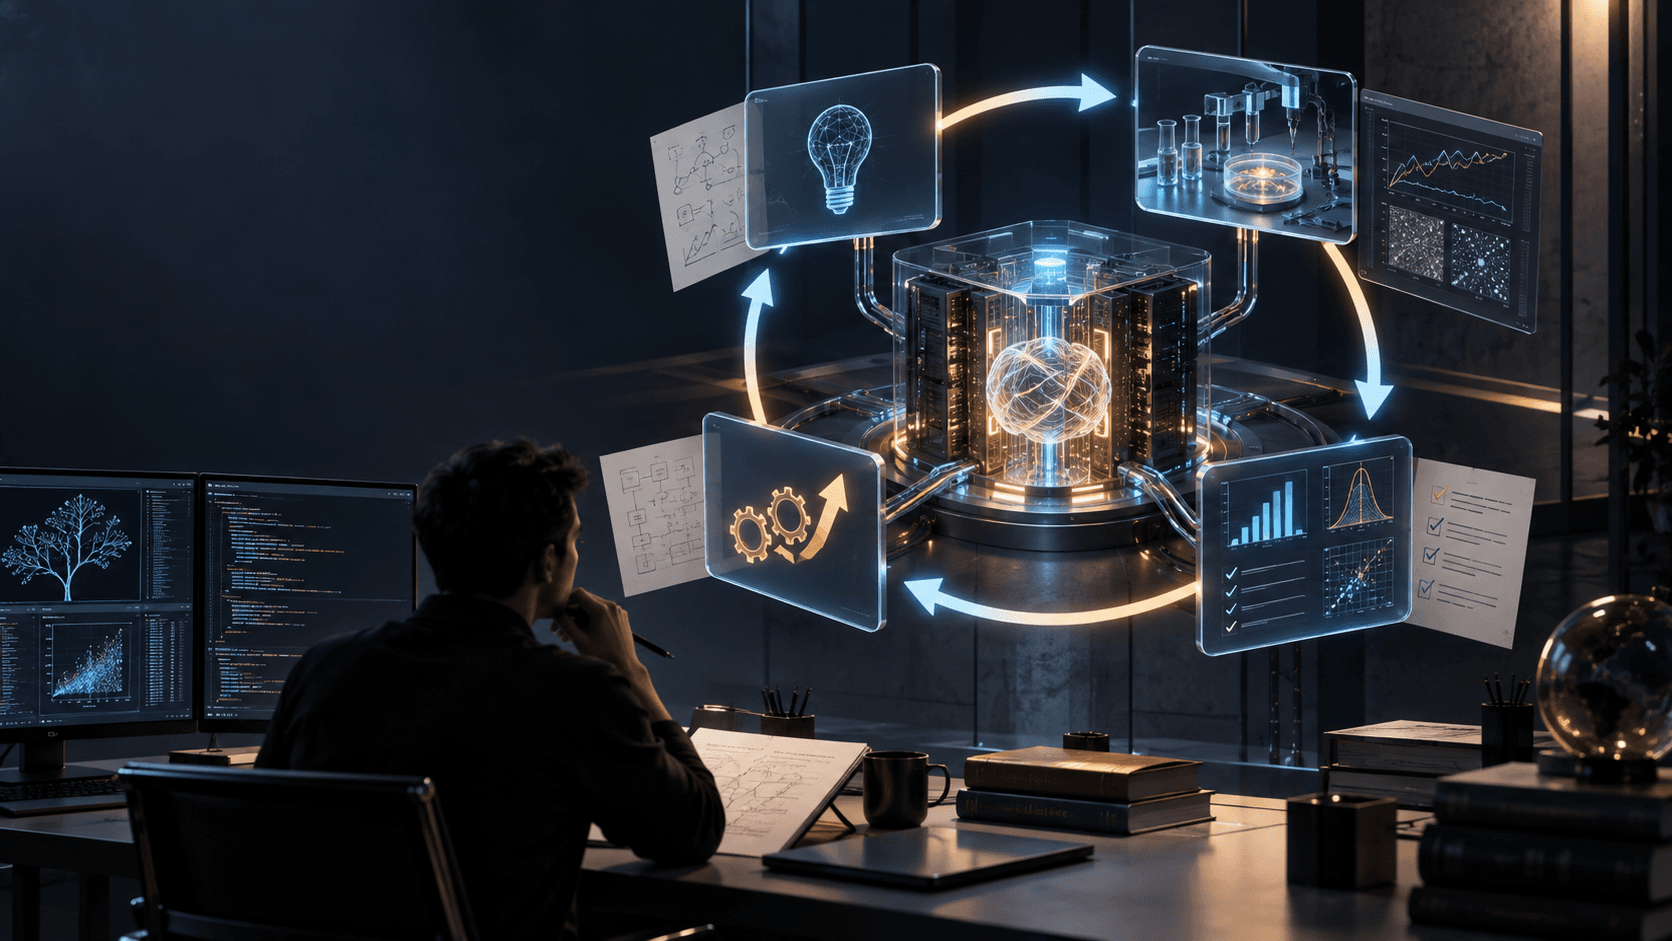
AI 研发的第一条闭环
过去的 AI 研发,大致是人提出想法,人写代码,人准备数据,人运行实验,人分析结果,再决定下一步做什么。AI 可以帮忙完成其中一小段,比如补一段代码,或者总结一篇论文,但方向和节奏仍然掌握在人手里。
现在,智能体开始把这些步骤串起来。它可以修改代码,运行实验,读取评估结果,再根据结果提出下一次修改。这个循环还不等于完整的 RSI,却已经让 AI 从一个回答问题的工具,变成了参与研发过程的合作者。
Anthropic 用了一句话描述这种变化:
“人类提出想法,模型负责实施、测试和评估,而且速度比过去快了一个数量级。”
这句话值得反复咀嚼。它描述的不是某个模型在排行榜上多拿了几分,而是研发流程中的分工正在变化。模型开始进入“做实验”这件事,AI 的进步不再只来自人类研究者手工完成的每一个环节。
从写代码,到自己安排实验
Anthropic 公布了一个很具体的例子:公司让 Claude 优化一段训练小型 AI 模型的代码。目标和正确性检查预先固定,Claude 要做的是改写代码、运行程序、计时,再重复这个过程。
这其实是一个缩小版的研究循环。它不是让模型凭空发明一个新学科,而是给它一个目标、一套约束和一套能够检查结果的实验环境。2025 年,这个实验中的 Claude Opus 4 平均实现了大约 3 倍加速;到 2026 年 4 月,Anthropic 披露的 Mythos Preview 达到了大约 52 倍。
这个数字很惊人,但不能被简单理解为“AI 的智力提升了 17 倍”。它说明的是:在目标清晰、结果可测量的优化任务里,模型已经能够持续寻找改进方案,而且迭代速度远高于人工逐步试错。换句话说,模型暂时还没有决定“研究什么”,却越来越擅长把一个已经定义好的研究问题往前推进。
更进一步的例子发生在 AI 安全研究中。Anthropic 描述的系统能够围绕一个开放问题提出假设、进行测试、让并行智能体分享发现,再根据结果继续迭代。在这项任务中,真正负责“怎么做下一步”的部分,已经不再完全由人类逐条安排。
但这里必须保留边界:人类仍然选择了问题,也设计了评分标准;这项结果没有直接证明生产规模的模型已经可以自主开展全部 AI 研究。
为什么这还不是完整的 RSI
RSI 这个词最近变得很热,但它其实没有一个所有人都接受的单一标准。
METR 的研究者提醒说,有人把任何“模型能力反馈到模型改进”的过程都称为 RSI;也有人认为,只有当反馈足以形成持续加速,甚至能够完全自主地制造继任系统时,才算真正的 RSI。定义不同,结论就会完全不同。
所以,看到一个模型会改自己的提示词、会重写一段代码,不能马上宣布“递归式自我改进来了”。我们至少要继续追问三个问题:
第一,它改进的是一次任务的表现,还是改进了之后所有任务的能力?
第二,它有没有能力自己发现值得研究的问题,而不是只优化人类交给它的问题?
第三,下一轮改进的结果,是否真的比上一轮更可靠,而不是找到了评估系统的漏洞?
这三道问题,把“会自我修改”与“会持续变得更强”区分开了。
真正的瓶颈,可能是验证
人类研发一个系统时,最大的价值不只是写代码,也包括判断什么问题值得做、怎样定义成功、结果是否可信。AI 进入研发闭环以后,这三件事不会自动消失,反而变得更加重要。
如果评价标准写错了,智能体可以非常高效地把错误目标优化到极致。如果奖励函数只奖励速度,系统可能牺牲准确性;如果测试集过于单一,模型可能只是学会了通过测试,而没有真正获得可迁移的能力。
这也是为什么 METR 不愿意只用一个“RSI 已经到来”或“RSI 还很遥远”的判断结束讨论。它更关心反馈的强度、实验的瓶颈,以及系统有没有能力验证自己的改进。IBM 采访的研究者也强调,今天很多自我改进方法仍然需要人类参与评估模型建议。
这件事对企业同样成立。一个可以自动修改流程的 AI智能体,不代表它知道什么是好流程。一个可以自动生成报告的系统,不代表它能判断报告是否误导了客户。自动化越深入,评价标准和审计机制就越不能含糊。
企业家应该先看见什么
如果把 RSI 直接理解成“未来某一天 AI 会自己进化”,我们很容易把它变成一个遥远的哲学问题。但如果把它拆成今天已经出现的局部闭环,很多企业马上就能看懂。
在 ContentHub 里,记者智能体负责寻找源头,编辑智能体判断真实性和时效性,写作智能体组织证据,主编智能体做终审,最后由 Lincoln 保留发布决定。它还不是一个自我改进的系统,但每一轮运行都会暴露新的问题:哪些来源值得长期跟踪,什么样的证据才能进入写作,什么样的文章最终会被打回。
如果下一轮系统能把这些反馈沉淀成更好的来源筛选、更准确的证据检查和更稳定的写作标准,它就开始接近一种“工作流层面的改进闭环”。这与模型自己设计下一代模型不是一回事,却是企业现在就可以建设的能力。
所以,企业家真正需要问的不是“我的公司什么时候拥有 RSI”,而是:我的 AI智能体能不能记住上一次失败?能不能把失败转化成下一次的检查规则?能不能在改进以后,让人清楚地知道它改了什么、为什么改、改完是否真的更好?
写在最后
Anthropic 的披露把未来拉近了一点,但它同时也提醒我们,不要把局部突破夸大成完整结论。
AI 正在从使用工具,走向参与制造工具;从执行人类安排好的任务,走向提出实验、比较结果和选择下一步。真正的 RSI 也许还没有到来,但“AI 帮助改进 AI”的早期形态,已经足够改变研发组织的工作方式。
未来最重要的竞争,不只是模型能不能变得更强,而是谁能建立更好的反馈、验证和治理系统。模型负责加速,组织负责判断;模型负责探索,人类仍然要决定什么值得被实现。
这可能正是 AI 时代最早的一条组织分界线:不是谁最早喊出了 RSI,而是谁最早学会了让每一次失败,都成为下一轮工作的起点。
本文基于 Anthropic Institute、METR 与 IBM Think 的公开资料,2026 年 9 月 18 日查阅。文中关于 ContentHub 的描述是分析案例,不代表来源文章中的事实。涉及 AI 产业与创业机会的讨论不构成投资建议。
关于 MindsLeap 心智悦动
MindsLeap 心智悦动是一家企业 AI 转型与 AI 原生创业加速平台。面向传统企业的 AI 转型,也服务 AI 原生企业、OPC 和科技创业者,连接产业场景、资本、硅谷资源与全球市场。
MindsLeap 是硅谷创新孵化器 Founders Space 的全球合作伙伴。通过 MindsLeap 企业家 AI 俱乐部、AI 培训、AI 咨询、FDE(Forward Deployed Engineer,现场部署工程)与创业加速服务,帮助企业从 AI 认知升级走向业务落地。
围绕 AI 原生组织建设,MindsLeap 正在构建一个连接企业家、创业者、AI 工程师、产业专家、投资人与全球创新资源的生态,帮助组织把 AI 真正落到业务流程、组织能力、产品创新和增长系统中。